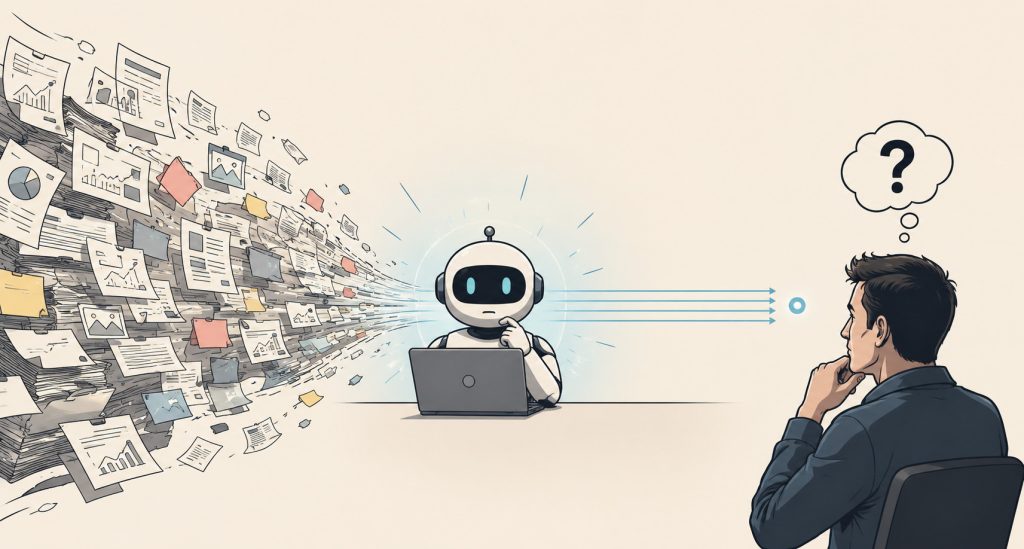
Lange Zeit folgte die Nutzung digitaler Werkzeuge einer einfachen Ökonomie: Verknappung zwang zur Präzision. Wer eine Datenbank abfragte, überlegte sich den Query. Wer eine Anzeige schaltete, feilte an jedem Wort. Das Werkzeug verlangte vom Menschen Disziplin, weil jede Interaktion Ressourcen kostete.
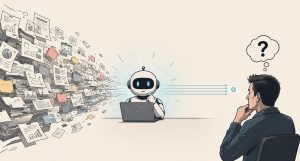
Large Language Models haben diese Dynamik ins Gegenteil verkehrt. Mit gigantischen Kontextfenstern von Millionen von Tokens und sinkenden API-Preisen entstand ein neues Phänomen: Tokenmaxxing. Die Praxis, gigantische Textmengen, ganze Dokumentensammlungen, Codebases und ungefilterte Rohdaten in den Prompt zu werfen, nach dem Motto: „Die KI wird sich das Richtige schon heraussuchen.“
Aktuelle Erhebungen zeichnen ein klares Bild dieser Praxis: Laut einem Bericht zur KI-Nutzung in Unternehmen nutzen bereits 71 % der Beschäftigten KI-Werkzeuge ohne offizielle IT-Genehmigung. Die Mitarbeitenden holen sich die Rechenleistung eigenmächtig, um den täglichen Arbeitsdruck zu bewältigen. Gleichzeitig zeigt eine detaillierte Aufstellung der KI-Kosten, dass die Preisspanne von einfachen Text-Prompts im Bruchteil eines Cents bis hin zu rechenintensiven Multi-Modal- und Video-Generierungen drastisch variiert. Doch während die Kosten pro einzelnem Token sinken, steigen die versteckten Gesamtkosten exponentiell.
Tokenmaxxing klingt nach maximaler Effizienz. Ist es aber nicht. Es ist die quantitative Illusion von Produktivität.
Das quantitative Missverständnis
Hier liegt die eigentliche Crux. Wir verwechseln den Input-Durchsatz mit der Output-Qualität. Mehr Daten in die KI einzuspeisen kostet scheinbar fast nichts. Aber es kostet etwas Wesentliches: Relevanz, Schärfe und logische Konsistenz.
„We confuse context window size with context comprehension.“
Wenn wir ein System mit 100.000 Tokens füttern, um eine Dreizeiler-Entscheidung zu generieren, lagern wir nicht nur die Suche aus – wir lagern die Relevanzfilterung aus. Das beschreiben KI-Forscher als das Phänomen des „Lost in the Middle“-Effekts: Je grösser der Kontext, desto höher die Wahrscheinlichkeit, dass kritische Details im Rauschen der Masse untergehen. Der Reibungsverlust beim selektiven Lesen und Filtern war kein lästiges Abfallprodukt. Er war der Prozess, durch den Kontext im menschlichen Gehirn überhaupt erst entstand.
Die Konsequenzen sind auf zwei Ebenen messbar: ökonomisch und kognitiv.
Ökonomisch führt unkontrolliertes Tokenmaxxing zu einer schleichenden Budget-Erosion. Wie Kostenanalysen zeigen, summieren sich Millionen „fauler“ Tokens über Tausende unregulierte Anfragen hinweg zu spürbaren Beträgen. Aber das finanzielle Budget ist das kleinere Problem. Das kognitive Budget ist das eigentliche Risiko.
Wenn 71 % der Belegschaft KI am zentralen Management vorbeischleusen, tun sie das meist mit minderwertigen Prompts: unstrukturierte Textwüsten rein, synthetische Textwüsten raus. Das Ergebnis ist eine Feedbackschleife der Mittelmässigkeit. Man umgeht die intellektuelle Durchdringung, die eine präzise Aufgabenstellung überhaupt erst ermöglicht.
Wir optimieren die Eingabe, aber wozu?
Das ist die eigentliche strategische Frage, die im Hype um riesige Kontextfenster nicht gestellt wird.
Wenn ich eine KI bitte, eine 50-seitige PDF-Datei ohne spezifische Instruktion zusammenzufassen, spare ich Zeit. Wenn ich von ihr erwarte, dass sie ohne mein Vorwissen die strategischen Risiken darin erkennt, spare ich Urteilskraft. Das ist kein gradueller Unterschied. Das ist ein kategorialer.
Ein Modell, das mit Tokenmaxxing gefüttert wird, liefert statistisch wahrscheinliche Zusammenfassungen. Es liefert keine Haltung. Wer ungeprüfte, vorverarbeitete Token-Massen akzeptiert, ohne die zugrundeliegende Struktur zu verstehen, verliert schrittweise die Fähigkeit zur kritischen Evaluation. Was übrig bleibt, ist das Abnicken von Synthesen, deren Herkunft niemand mehr zurückverfolgen kann.
„Ein Manager, der KI nur noch mit unendlichen Datenströmen füttert, ohne die Kernfragen selbst zu schärfen, steuert nicht mehr. Er ist eine reine Durchlaufstation für synthetisches Rauschen geworden.“
Wohin führen wir die Kultur?
Der weit verbreitete Glaubenssatz lautet: „Die Modelle werden schlau genug sein, um jeden Müll zu sortieren.“ Das ist eine normative Hoffnung, keine empirische Realität.
Die Realität in den Unternehmen zeigt: Die 71 % Schatten-IT entsteht nicht aus Böswilligkeit, sondern aus dem Fehlen klarer, intelligenter Workflows. Wo keine Kultur der präzisen Prompt-Disziplin herrschen kann, dominiert die reine Masse. Tokenmaxxing wird zum Faulheitskompromiss der Wissensarbeit.
Die wertvollsten Experten der kommenden Jahre werden nicht diejenigen sein, die die meisten Tokens durch die APIs jagen. Es werden diejenigen sein, die Informations-Architekturen so reduzieren können, dass mit minimalem Token-Einsatz maximale mathematische und logische Präzision erreicht wird.
Was wir daraus ableiten müssen
Drei Schlussfolgerungen für den strategischen Umgang mit KI im Unternehmen:
- Token-Effizienz ist Denk-Disziplin. Ein präziser Prompt mit 500 Tokens fokussiertem Kontext schlägt ein ungefiltertes 50.000-Token-Dokument nahezu immer in Logik und Handlungsrelevanz. Wer präzise promptet, muss vorher präzise gedacht haben.
- Schatten-IT schadet vor allem der Qualität. Die 71 % inoffizielle Nutzung ist kein reines IT-Sicherheitsproblem, es ist ein Qualitätsproblem. Wenn Mitarbeitende ohne Governance „tokenmaxxen“, entstehen irrelevante Berichte, die Zeit kosten statt sparen.
- Kognitive Ergonomie vor Datenvolumen. Wir müssen unterscheiden zwischen Daten-Upload und Problem-Definition. Ersteres ist ein technischer Vorgang. Letzteres ist menschliche Kernkompetenz.
Die entscheidende Frage lautet nicht: „Wie viele Tokens passen in meinen Prompt?“
Sondern: „Wie viel eigenes Denken habe ich investiert, bevor ich auf ‚Senden‘ gedrückt habe?“
Du brauchst Unterstützung? Wir helfen dir!
Egal, ob du gerade erst mit LinkedIn startest oder bestehende Prozesse optimieren möchtest – wir sind dein Partner. Gemeinsam entwickeln wir einen Fahrplan, der dein Unternehmen sicher und zukunftsfähig macht.
Wir bieten ein unverbindliches, kostenloses Beratungsgespräch an, damit du dich von unserer Expertise überzeugen kannst. Folge uns auch auf LinkedIn für weitere Updates!